ChatGPT의 GPT에서 마지막 T는 트랜스포머(Transformer)예요. 이 구조의 시작점은 2017년 6월 arXiv에 올라온 논문 한 편이에요. 구글 브레인과 구글 리서치 연구진을 중심으로 8명이 쓴 「Attention Is All You Need」예요.
이 글은 그 논문에 실린 그림 3장을 그대로 가져와 설명해요. 논문에는 “출처를 밝히면 보도·학술 목적으로 표와 그림을 재사용해도 된다”는 Google의 허가 문구가 붙어 있어서, 원본 그림을 직접 보면서 따라갈 수 있어요.
트랜스포머가 풀려던 문제: 한 단어씩 차례로 읽는 방식
트랜스포머 이전에 번역 같은 문장 처리를 주도한 건 RNN(순환 신경망)과 그 변형인 LSTM이었어요. 이 방식은 문장을 앞에서부터 한 단어씩 읽어요. 앞 단어를 처리한 결과가 있어야 다음 단어를 처리할 수 있죠.
논문은 바로 이 점을 문제로 짚어요. 순서대로 계산해야 하니 학습할 때 한 문장 안에서 병렬 처리를 할 수 없고, 문장이 길어질수록 더 불리해진다는 거예요. 그래서 연구진은 순환 구조를 아예 빼고 어텐션(attention)만으로 문장 안 단어들의 관계를 잡는 구조를 내놓았어요. 논문 제목이 “어텐션만 있으면 된다”인 이유예요.
그림 1: 왼쪽은 읽는 쪽, 오른쪽은 쓰는 쪽
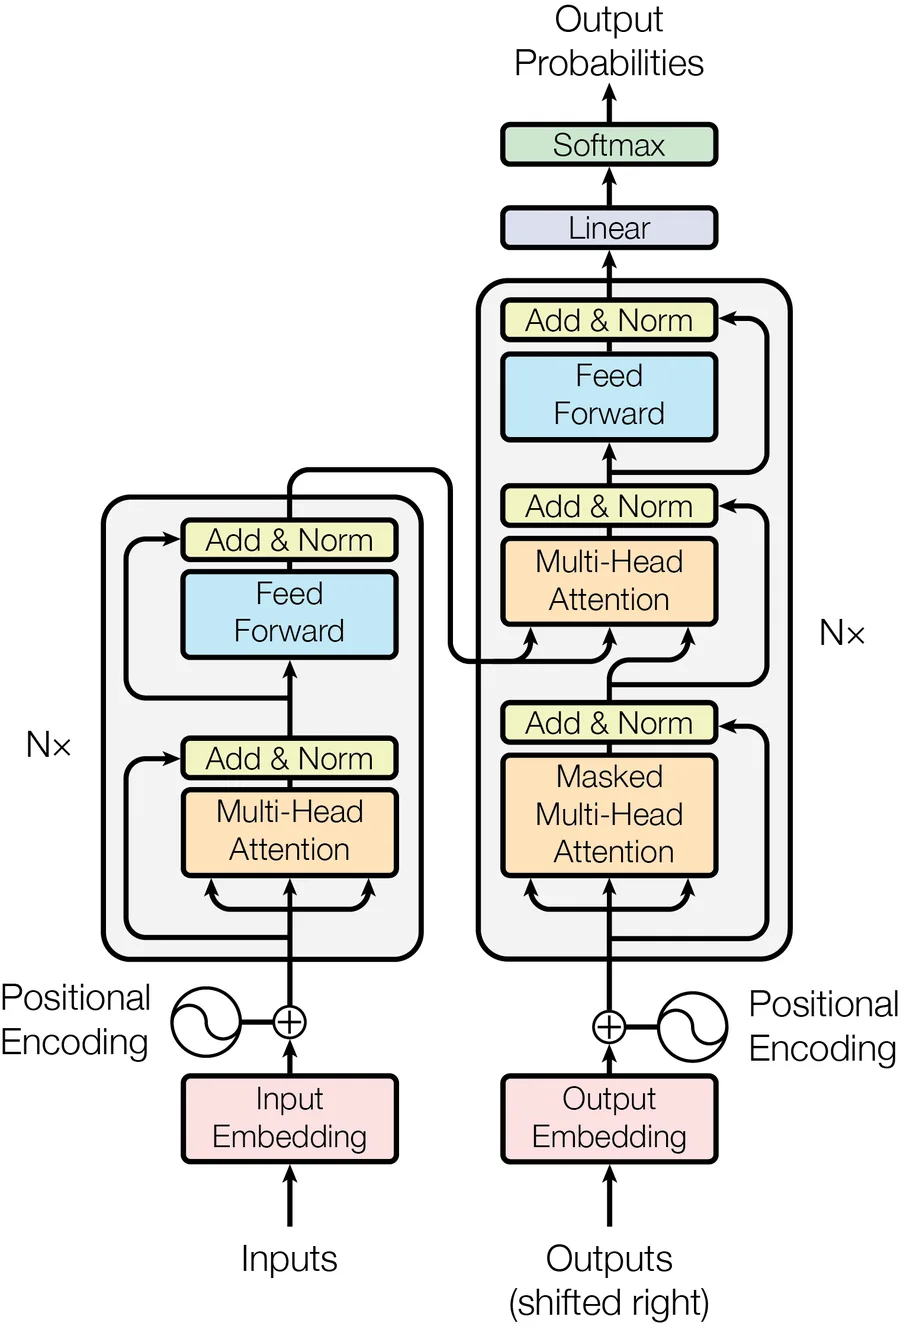
이미지: Vaswani 외, 「Attention Is All You Need」 그림 1 (Google 허가에 따라 재사용)
AI 관련 글에서 한 번쯤 봤을 그 그림이에요. 크게 두 덩어리로 나뉘어요.
- 왼쪽, 인코더: 입력 문장(예: 번역할 영어 문장)을 읽고 각 단어의 의미를 문맥까지 담은 숫자 묶음으로 바꿔요. 논문 기본 모델은 같은 층을 6개(N=6) 쌓았어요. 각 층은 멀티헤드 어텐션과 피드포워드 신경망, 이렇게 두 부분으로 되어 있어요.
- 오른쪽, 디코더: 출력 문장(예: 독일어 번역)을 한 단어씩 만들어요. 역시 6층이고, 층마다 부분이 하나 더 있어요. 가운데 어텐션 층이 인코더 쪽 결과를 참고해서 “원문의 어느 부분을 보고 지금 단어를 쓸지”를 정해요.
디코더 맨 아래 어텐션에는 ’Masked’가 붙어 있어요. 문장을 만드는 중에 아직 쓰지 않은 뒤쪽 단어를 미리 보지 못하게 가리는 장치예요. 이 부분이 나중에 GPT와 연결되니 기억해 두세요.
그림 아래쪽의 위치 인코딩(Positional Encoding)도 눈여겨볼 만해요. 순서대로 읽는 구조를 버렸으니 모델은 그대로 두면 단어 순서를 알 수 없어요. 그래서 각 단어에 “몇 번째 자리인지”를 사인·코사인 함수로 만든 값으로 더해 줘요.
그림 2: 어텐션은 결국 “어떤 단어를 얼마나 볼지” 정하는 계산
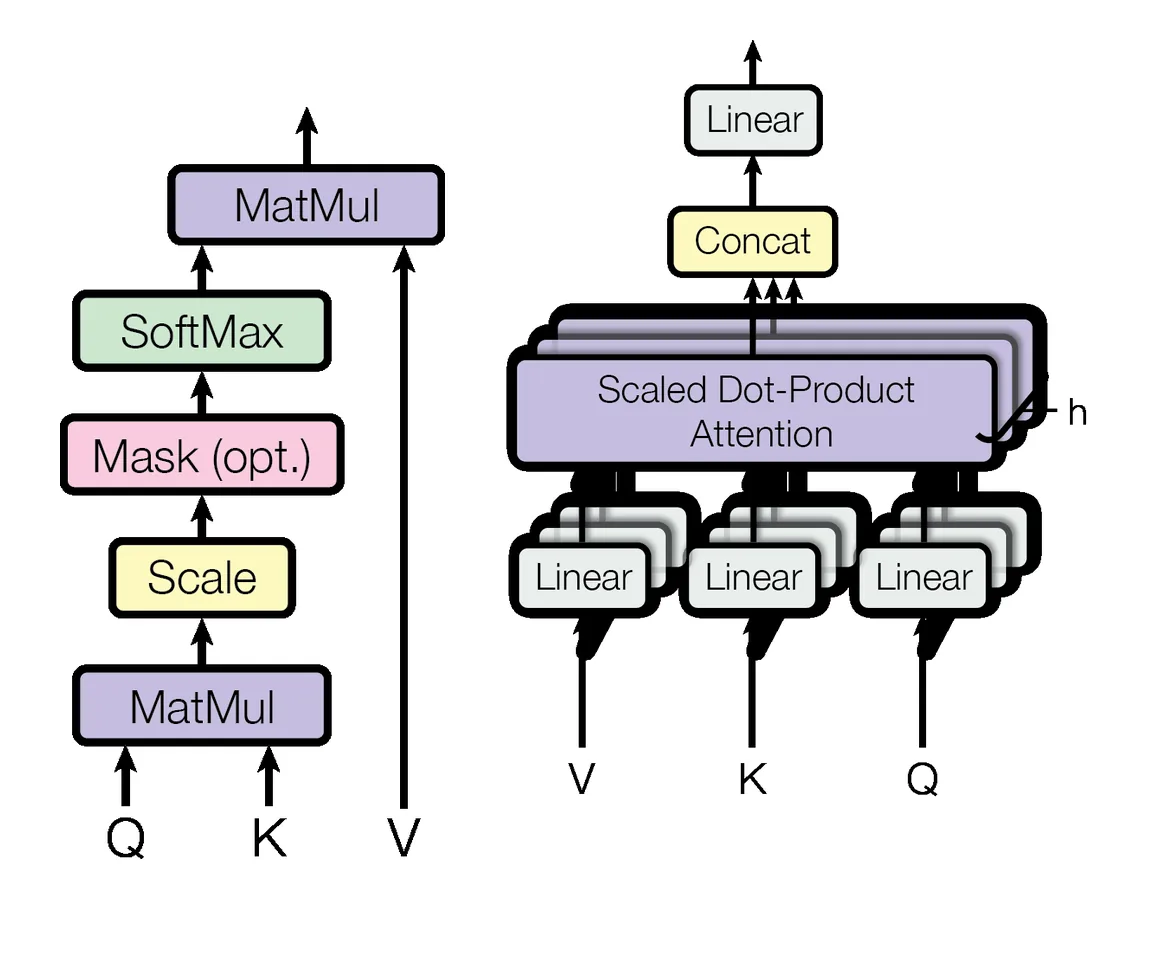
이미지: Vaswani 외, 「Attention Is All You Need」 그림 2 (Google 허가에 따라 재사용)
왼쪽 그림이 어텐션 한 번의 계산 순서예요. 등장하는 Q, K, V는 각각 Query(질문), Key(열쇠), Value(값)예요. 도서관에 빗대면 이해가 쉬워요.
- 지금 처리 중인 단어가 “나랑 관련 있는 단어가 뭐지?“라는 질문(Q)을 던져요.
- 문장 속 모든 단어는 자기 열쇠(K)를 내밀어요. 질문과 열쇠를 곱해(MatMul) 얼마나 잘 맞는지 점수를 매겨요.
- 점수를 SoftMax로 비율(합이 1인 가중치)로 바꿔요.
- 그 비율대로 각 단어의 값(V)을 섞어요. 관련 깊은 단어의 정보가 많이 섞이는 거죠.
논문이 붙인 공식은 softmax(QKᵀ / √dₖ) V 한 줄이에요. 중간의 Scale 단계, 즉 √dₖ로 나누는 이유도 논문에 나와요. 벡터 차원(dₖ)이 크면 곱한 값이 너무 커져서 SoftMax가 한쪽으로 쏠리고, 그러면 학습 신호(기울기)가 아주 작아진다는 거예요.
오른쪽은 이 계산을 여러 개 동시에 돌리는 멀티헤드 어텐션이에요. 기본 모델은 8개 헤드(h=8)를 쓰고, 각 헤드는 512차원 정보를 64차원으로 줄여서 봐요. 하나의 시선 대신 8개의 서로 다른 시선으로 문장을 보는 셈이에요.
그림 3: ’its’는 누구를 가리킬까
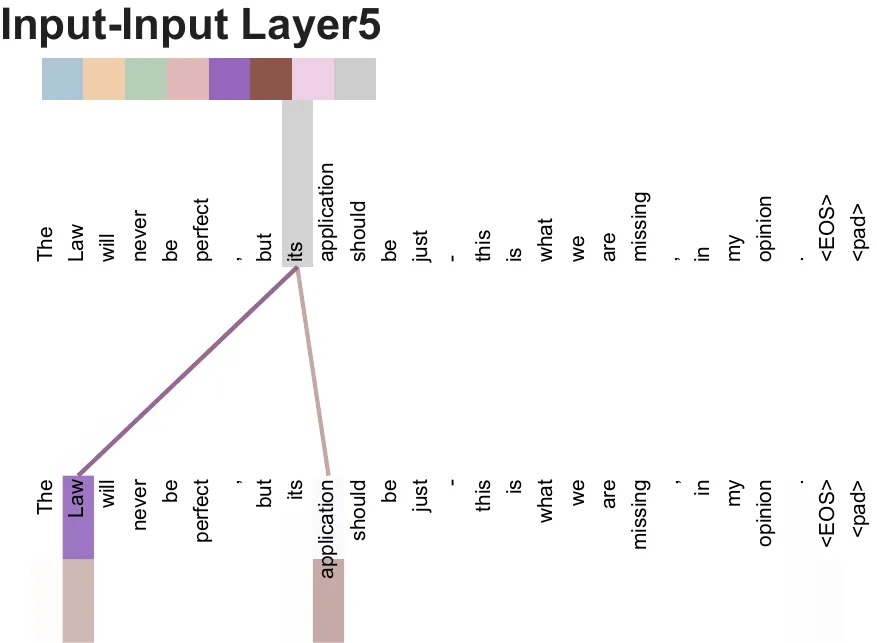
이미지: Vaswani 외, 「Attention Is All You Need」 그림 4 일부 (Google 허가에 따라 재사용)
어텐션이 실제로 뭘 배우는지 보여 주는 그림이에요. “The Law will never be perfect, but its application should be just”라는 문장에서 ’its’가 어느 단어를 보는지 선으로 그렸어요. 6층 중 5번째 층의 헤드 두 개가 ’its’에서 ’Law’와 ’application’으로 강하게 연결돼 있죠. ’its’가 ’Law’를 가리킨다는, 사람이라면 당연히 아는 관계를 모델이 스스로 잡아낸 거예요.
다만 논문도 이 부분은 조심스럽게 써요. 대명사 해석에 “관여하는 것으로 보인다(apparently involved)“는 표현이에요. 시각화 몇 장으로 모델 내부를 다 설명할 수는 없다는 점도 함께 기억해 두면 좋아요.
성적표: 더 빨리 배우고, 번역도 더 잘했다
논문은 번역 실험으로 성능을 보여 줬어요.
| 항목 | 기본 모델 (base) | 큰 모델 (big) |
|---|---|---|
| 파라미터 수 | 약 6,500만 | 약 2억 1,300만 |
| 학습 시간 (P100 GPU 8개) | 12시간 | 3.5일 |
| 영어→독일어 BLEU | 27.3 | 28.4 |
| 영어→프랑스어 BLEU | 38.1 | 41.8 |
큰 모델의 영어→독일어 점수 28.4는 여러 모델을 합친 앙상블까지 포함한 기존 최고 기록보다 2점 넘게 높았어요. 기본 모델만으로도 기존에 발표된 모든 모델을 넘었고요. 핵심은 학습 비용이에요. GPU 8개로 12시간, 길어야 3.5일이면 충분했어요.
원문을 꼼꼼히 보면 작은 불일치가 하나 있어요. 영어→프랑스어 점수가 초록과 표에는 41.8인데, 본문 결과 설명 문단에는 41.0으로 적혀 있어요. 현재 arXiv 최신판(v7) 기준이에요. 인용할 때는 초록과 표의 41.8이 많이 쓰이지만, 이런 차이가 있다는 걸 알고 쓰는 편이 안전해요.
GPT는 오른쪽을, BERT는 왼쪽을 가져갔다
그림 1을 다시 떠올려 보면, 이후 유명해진 두 모델의 차이를 한 번에 정리할 수 있어요.
GPT는 디코더 쪽이에요. OpenAI의 첫 GPT 논문 제목은 「Improving Language Understanding by Generative Pre-Training」이고, 본문에 “다층 트랜스포머 디코더”를 언어 모델로 썼다고 밝혀요. 구체적으로는 마스크드 셀프 어텐션을 쓰는 12층짜리 디코더 전용(decoder-only) 모델이에요. 인코더가 없으니 그림 1 오른쪽에서 인코더 결과를 받는 가운데 층이 빠지고, 마스크드 어텐션과 피드포워드만 남아요. 앞 단어들만 보고 다음 단어를 맞히는 구조라, 글을 이어 쓰는 데 잘 맞아요.
BERT는 인코더 쪽이에요. 이름부터 ‘Bidirectional Encoder Representations from Transformers’, 트랜스포머의 인코더로 만든 양방향 표현이라는 뜻이에요. 마스크 없이 문장 앞뒤를 동시에 보기 때문에, 글을 새로 쓰기보다는 문장을 이해하고 분류하는 일에 강해요. 2018년 10월 arXiv에 공개됐어요.
정리하면 이래요.
| 원조 트랜스포머 | GPT | BERT | |
|---|---|---|---|
| 쓰는 부분 | 인코더 + 디코더 | 디코더 | 인코더 |
| 문장 보는 방향 | 인코더는 양방향, 디코더는 앞쪽만 | 앞쪽만 | 양방향 |
| 잘하는 일 | 번역 | 이어 쓰기, 생성 | 이해, 분류 |
이 그림을 알면 무엇이 보이나
트랜스포머 구조를 알면 AI 뉴스의 용어가 훨씬 덜 낯설어져요. 모델의 “컨텍스트 길이”는 어텐션이 한 번에 볼 수 있는 토큰 수예요. 그림 2처럼 모든 단어 쌍의 점수를 매겨야 하니, 문장 길이가 두 배가 되면 점수 계산은 네 배로 늘어요. 논문도 셀프 어텐션의 계산량이 문장 길이의 제곱에 비례한다고 표로 정리했어요. 긴 컨텍스트가 비싼 이유예요. “파라미터 수”는 그림 1의 층들 안에 든 숫자의 총량이에요.
GPT와 BERT가 보여 주듯, 이후 모델들은 이 그림의 일부를 떼어 내거나 키우는 식으로 발전했어요. 새 모델 소식을 볼 때 “이건 그림 1의 어느 쪽을 어떻게 바꾼 걸까?“라고 물어보면 기사 내용을 따라가기가 한결 쉬워질 거예요.