새 AI 모델이 나올 때마다 “컨텍스트 100만 토큰”이 큰 글씨로 따라붙어요. 그러다 보니 계약서든 회의록이든 일단 통째로 넣고 물어보면 AI가 다 읽고 답해 줄 거라고 믿기 쉽죠.
반은 맞아요. 그 길이까지 넣을 수는 있거든요. 문제는 넣은 만큼 제대로 쓰느냐예요. 이 글은 그 차이를 다룬 논문과 벤치마크를 원문으로 확인한 다음, QuestBrief 운영자가 딥시크(DeepSeek)로 같은 현상을 직접 시험해 본 결과를 함께 실었어요.
컨텍스트 창은 ’책상 크기’일 뿐이다
컨텍스트 창은 모델이 한 번에 받아들일 수 있는 입력의 최대 길이예요. 책상이 넓다는 뜻이지, 책상 위 서류를 전부 꼼꼼히 읽는다는 뜻은 아니에요.
이 구분을 처음 널리 알린 건 2023년 스탠퍼드 등 연구진의 「Lost in the Middle」이에요. 문서 20~30개를 주고 그중 하나에 든 답을 찾게 하면서, 정답 문서의 위치만 바꿔 봤어요. 정답이 맨 앞이나 맨 끝에 있을 때 성적이 가장 좋았고, 가운데로 갈수록 떨어졌어요. GPT-3.5-Turbo는 위치에 따라 20% 넘게 떨어졌고, 가장 나쁜 경우에는 문서를 아예 안 줬을 때(56.1%)보다도 낮았어요. 자료를 준 게 오히려 손해였던 셈이죠.
같은 논문에서 하나 더 눈에 띄는 결과가 있어요. 4K 모델과 그 16K 확장판(GPT-3.5-Turbo), 8K와 100K 확장판(Claude-1.3)을 같은 입력으로 비교했더니 성적이 거의 같았어요. 창을 늘렸다고 더 잘 읽는 게 아니었던 거예요. 검색 문서를 20개에서 50개로 늘려도 GPT-3.5-Turbo의 성적은 1.5% 정도밖에 오르지 않았고요.
‘바늘 찾기’ 만점이 믿을 만하지 않은 이유
모델 발표에서 자주 보이는 긴 문맥 성적이 “건초더미에서 바늘 찾기”예요. 긴 글 속에 문장 하나를 숨기고 찾게 하는 시험이죠. 2024년 NVIDIA 연구진의 RULER는 이 시험을 조금씩 어렵게 바꿔 봤어요. 32K 이상을 지원한다는 모델 17개를 13개 과제로 시험했는데, 기본 바늘 찾기는 거의 다 잘했지만 32K에서 만족할 만한 성적을 유지한 건 절반뿐이었어요.
더 결정적인 건 2025년 ICML에 실린 NoLiMa예요. 기존 바늘 찾기는 질문과 숨긴 문장이 같은 단어를 공유하는 경우가 많아서, 사실상 단어 맞추기로 풀 수 있었어요. NoLiMa는 그 고리를 끊었어요. 예를 들어 “젬퍼 오페라 하우스 옆에 산다”는 문장을 숨겨 두고 “드레스덴에 가 본 사람은?“이라고 묻는 식이에요. 모델이 두 표현을 의미로 이어야 풀 수 있죠.
결과는 꽤 냉정했어요. 128K 이상을 지원한다는 13개 모델 중 11개가 32K에서 짧은 글 성적의 절반 아래로 떨어졌어요. GPT-4o도 99.3%에서 69.7%가 됐고요. 이후 연구팀이 결과표에 추가한 모델들의 ‘유효 길이’(짧은 글 성적의 85%를 유지하는 최대 길이)는 이래요.
| 모델 | 광고한 길이 | NoLiMa 유효 길이 |
|---|---|---|
| GPT-4.1 | 1M | 16K |
| GPT-4o | 128K | 8K |
| Claude 3.5 Sonnet | 200K | 4K |
| Gemini 2.5 Flash (thinking 끔) | 1M | 2K |
| Llama 4 Scout | 10M | 1K |
출처: NoLiMa GitHub 결과표. 2025년에 시험한 모델 기준이라, 이후 나온 모델의 성적은 아니에요.
같은 모델도 시험 방식에 따라 숫자가 크게 달라진다는 점은 짚어 둘게요. Gemini 1.5 Pro는 RULER 결과표에서 128K 넘게까지 기준을 넘었는데, NoLiMa에서는 유효 길이가 2K였어요. “이 모델은 몇 K까지 쓸 만하다”는 숫자 하나는 없다는 얘기예요. 무엇을 시키느냐에 따라 달라지니까요.
찾아 줘도 틀린다
여기까지는 “긴 글에서 못 찾는다”는 얘기로 들릴 수 있어요. 2025년 10월 arXiv에 올라온 「Context Length Alone Hurts LLM Performance Despite Perfect Retrieval」은 한 발 더 나가요. 필요한 정보를 모델이 완벽하게 찾을 수 있는 조건에서도 입력이 길어지면 성적이 13.9~85% 떨어졌다고 보고했어요.
실험 설계가 재미있어요. 관련 없는 글을 공백으로 바꿔도, 아예 모델이 보지 못하게 가려도 성적이 떨어졌거든요. 방해하는 내용 때문이 아니라 길이 자체가 문제라는 결론이에요. 다만 시험한 모델은 다섯 개뿐이고, GPT-4o 같은 비공개 모델은 오픈 모델보다 훨씬 덜 흔들렸다는 점도 함께 적혀 있어요.
같은 논문이 내놓은 해결법은 간단해요. 모델에게 먼저 관련 근거를 그대로 옮겨 적게 한 다음, 그 짧은 내용으로 문제를 풀게 하는 거예요. Mistral 모델은 26K 길이에서 정확도가 35.5%에서 66.7%로 올랐어요.
벡터 DB 회사 Chroma가 2025년 7월 공개한 기술 보고서 「Context Rot」도 같은 방향이에요. Claude Opus 4, o3, Gemini 2.5 Pro를 포함한 18개 모델을 시험했는데, 단순한 과제에서도 입력이 길어질수록 성적이 불안정해졌다고 해요. 대화 기억 과제에서는 관련 부분만 담은 약 300토큰 입력이 전체 약 11만 3천 토큰 입력보다 훨씬 좋은 성적을 냈고요. 정답과 비슷하지만 틀린 문장이 하나만 섞여도 성적이 떨어졌다는 결과도 있어요. 학술지 논문이 아니라 회사 보고서라는 점은 감안해야 해요.
딥시크로 직접 해 봤다
논문 속 모델은 대부분 2025년 이전 모델이에요. 지금 쓰는 서비스에서도 그럴까 싶어서, 운영자가 11월 5일 딥시크 웹 채팅(DeepThink 끔, 웹 검색 끔)으로 작은 실험을 해 봤어요.
긴 글은 고전 소설 『구운몽』 전문(공백 포함 약 8만 5천 자)을 썼어요. 그 안에 원작에 없는 문장을 심었어요. 50% 지점에 정답 문장 “이때 관악산 깊은 골에 노루 한 마리 있어 바위를 훌쩍 뛰어넘더라.“를 넣었어요. 25% 지점에는 “북한산 높은 봉우리에 사슴 한 마리 있어 계곡을 훌쩍 뛰어넘더라.”, 75% 지점에는 “관악산 너른 들에 꿩 한 마리 있어 소나무 가지에 날아 앉더라.“라는 방해 문장을 넣었고요. 질문은 “글에서 서울대학교 근처 산에서 뛰어오른 동물은 무엇인가?“예요. 질문에 ’관악산’도 ’노루’도 없으니, NoLiMa처럼 의미로 이어야 풀 수 있어요.
시험은 매번 새 채팅에서, 글과 질문을 한 메시지에 담아 보냈어요.
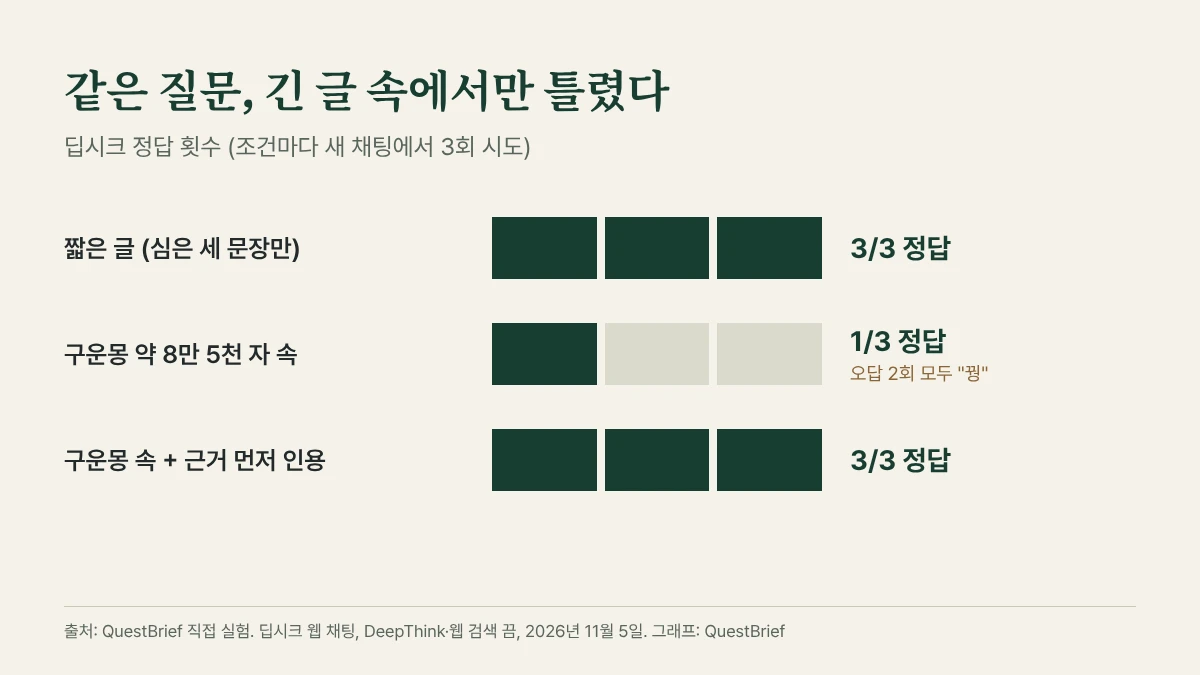
그래프: QuestBrief 직접 실험 (딥시크 웹 채팅, DeepThink 끔, 2026년 11월 5일)
방해 문장 없이 노루 문장만 넣었을 때는 현대어로 쓰든 고전 문체로 쓰든 바로 찾아냈어요. 흔들리기 시작한 건 방해 문장 두 개를 넣고부터예요. 세 번 중 두 번은 꿩이라고 답했거든요. 그중 한 번은 답변 끝에 “앞부분에는 관악산 깊은 골에서 노루가 뛰어넘는 묘사도 나온다”고 직접 적어 놓고도 꿩을 골랐어요. 정답 문장을 찾고도 판단에서 틀린 거예요. 나머지 한 번은 노루를 맞혔지만 꿩 문장은 아예 찾지 못했고요.
같은 세 문장과 같은 질문을 구운몽 없이 그대로 보내면 어땠을까요? 세 번 모두 노루였어요. 그러니 질문 표현이 애매해서 틀렸다고 보기는 어렵죠. 같은 내용이 긴 글 속에 들어가자 판단이 흐려진 거예요.
마지막으로 질문 끝에 한 줄을 붙였어요. “먼저 답의 근거가 될 수 있는 문장을 원문 그대로 모두 인용하고, 각 문장이 질문의 조건에 맞는지 하나씩 따져 본 다음 최종 답을 말해 줘.” 그러자 세 번 모두 노루를 맞혔어요. 첫 시도에서는 세 문장을 다 인용한 다음, 북한산은 서울대 근처가 아니고 꿩은 날아 앉았을 뿐이라며 하나씩 지워 나갔어요. 앞에서 본 Du 외 논문의 해결법이 딥시크에서도 그대로 통한 셈이에요.
이 실험의 한계도 분명해요. 모델 하나로 조건마다 세 번씩 한 작은 실험이라 벤치마크라고 부를 수는 없어요. 딥시크가 구운몽 원작을 알고 있어서 “원작에 없는 문장”을 골라내는 식으로 찾았을 가능성도 있어요. 실제로 한 번은 “본문 중간에 삽입된 문장”이라고 표현했거든요. 처음 보는 문서였다면 찾는 것부터 더 어려웠을 수 있어요. 질문의 “뛰어오른”과 노루 문장의 “뛰어넘더라”가 완전히 같은 말이 아니라는 점도 있지만, 짧은 글에서는 세 번 다 맞혔으니 이것만으로 오답을 설명하기는 어려워요. 토큰 수는 웹 채팅에서 확인할 수 없어서 글자 수로만 적었어요.
딥시크에게 컨텍스트 길이를 직접 물어보면 1M이라고 답할 때도, 128K라고 답할 때도 있었어요. 모델은 자기 사양을 정확히 모르는 경우가 많으니 공식 문서를 보는 게 맞아요. API 문서에는 두 모델 모두 1M으로 적혀 있지만, 웹 채팅의 입력 한도는 나와 있지 않았어요. 다만 딥시크가 25%, 50%, 75% 위치의 문장을 모두 인용한 적이 있으니, 글이 잘려서 틀린 건 아니에요.
긴 문서를 넣을 때 바꿀 습관
논문들과 이번 실험이 가리키는 방향은 같아요. 긴 문서를 통째로 넣는 건 괜찮지만, 그 안에서 비슷한 내용끼리 헷갈리기 쉬운 질문일수록 결과를 그대로 믿으면 안 돼요. 버전이 다른 계약서, 초안과 최종본, 비슷한 회의록 여러 개를 한꺼번에 넣는 경우가 딱 그래요.
가장 효과가 컸던 방법은 이번 실험에서 쓴 그 한 줄이에요. 답을 바로 달라고 하지 말고, **“근거가 될 수 있는 문장을 원문 그대로 모두 인용한 다음, 조건에 맞는지 하나씩 따져서 답해 줘”**라고 물어보세요. 정답률이 오르는 것도 좋지만, AI가 인용한 문장을 내가 원문에서 바로 확인할 수 있다는 게 더 큰 장점이에요. 인용이 엉뚱하면 답도 믿지 않으면 되니까요.