AI 서비스 소개에서 “RAG 기반”이라는 말을 자주 보게 돼요. RAG는 Retrieval-Augmented Generation의 줄임말로, 우리말로는 검색 증강 생성이라고 해요. 이름 그대로 AI가 답을 만들기(생성) 전에 관련 문서를 먼저 찾아서(검색) 그 내용을 보태는(증강) 방식이에요.
이 글은 RAG를 처음 제안한 2020년 논문부터, 실제로 RAG를 만들어 본 연구팀들이 정리한 실패 사례까지 순서대로 짚어요. 그림은 모두 CC BY 4.0 라이선스로 공개된 논문에서 가져왔어요.
AI는 왜 따로 검색을 해야 할까
대형 언어 모델(LLM)은 학습할 때 본 내용을 모델 안의 숫자(가중치)에 담아 둬요. 여기에는 세 가지 한계가 있어요.
- 학습 이후의 정보를 몰라요. 모델이 만들어진 뒤에 바뀐 사실은 반영되지 않아요.
- 회사 내부 문서처럼 처음부터 본 적 없는 정보는 답할 수 없어요.
- 그럴듯하지만 틀린 답을 만들 수 있어요. 이를 할루시네이션(hallucination)이라고 해요.
RAG라는 이름을 널리 알린 논문은 2020년 5월 arXiv에 올라온 「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」예요. 이 논문은 지식을 두 종류로 나눠요. 모델 가중치에 담긴 파라메트릭 메모리와, 밖에서 꺼내 보는 비파라메트릭 메모리예요. 논문에서는 위키백과를 벡터 색인으로 만들어 바깥 기억으로 썼어요. 그 결과 질의응답 과제 세 가지에서 최고 성적을 냈고, 바깥 기억이 없는 모델보다 더 구체적이고 사실에 맞는 문장을 만들었다고 보고했어요.
쉽게 말해 RAG는 AI에게 오픈북 시험을 보게 하는 방법이에요. 외운 것만으로 답하지 않고, 책을 펴서 관련 쪽을 찾아본 뒤 답하게 하는 거죠.
RAG는 두 단계로 돌아간다
실제 RAG 시스템을 만든 경험을 정리한 2024년 논문 「Seven Failure Points When Engineering a RAG System」은 RAG를 두 과정으로 나눠 설명해요.
1. 색인 과정 (미리 해 두는 일)
- 문서를 작은 조각(청크, chunk)으로 자르고, 각 조각을 임베딩으로 바꿔요. 임베딩은 글의 의미를 숫자 목록(벡터)으로 압축한 거예요.
- 원문 조각과 임베딩을 함께 데이터베이스에 저장해요. 흔히 말하는 “벡터 DB”가 이 역할이에요.
- 논문은 조각 크기가 까다로운 선택이라고 짚어요. 너무 작으면 답할 수 없는 질문이 생기고, 너무 크면 답에 잡음이 섞여요.
2. 질의 과정 (질문이 들어올 때마다 하는 일)
- 질문을 검색하기 좋게 다시 쓰고, 임베딩으로 바꿔요.
- 데이터베이스에서 의미가 가장 가까운 조각 K개를 찾아요.
- 찾은 조각을 관련도 순으로 다시 정렬하고(리랭킹), 모델이 한 번에 받을 수 있는 분량에 맞게 정리해요.
- 마지막으로 LLM이 질문과 조각을 함께 읽고 답을 써요.
검색했는데도 틀리는 경우
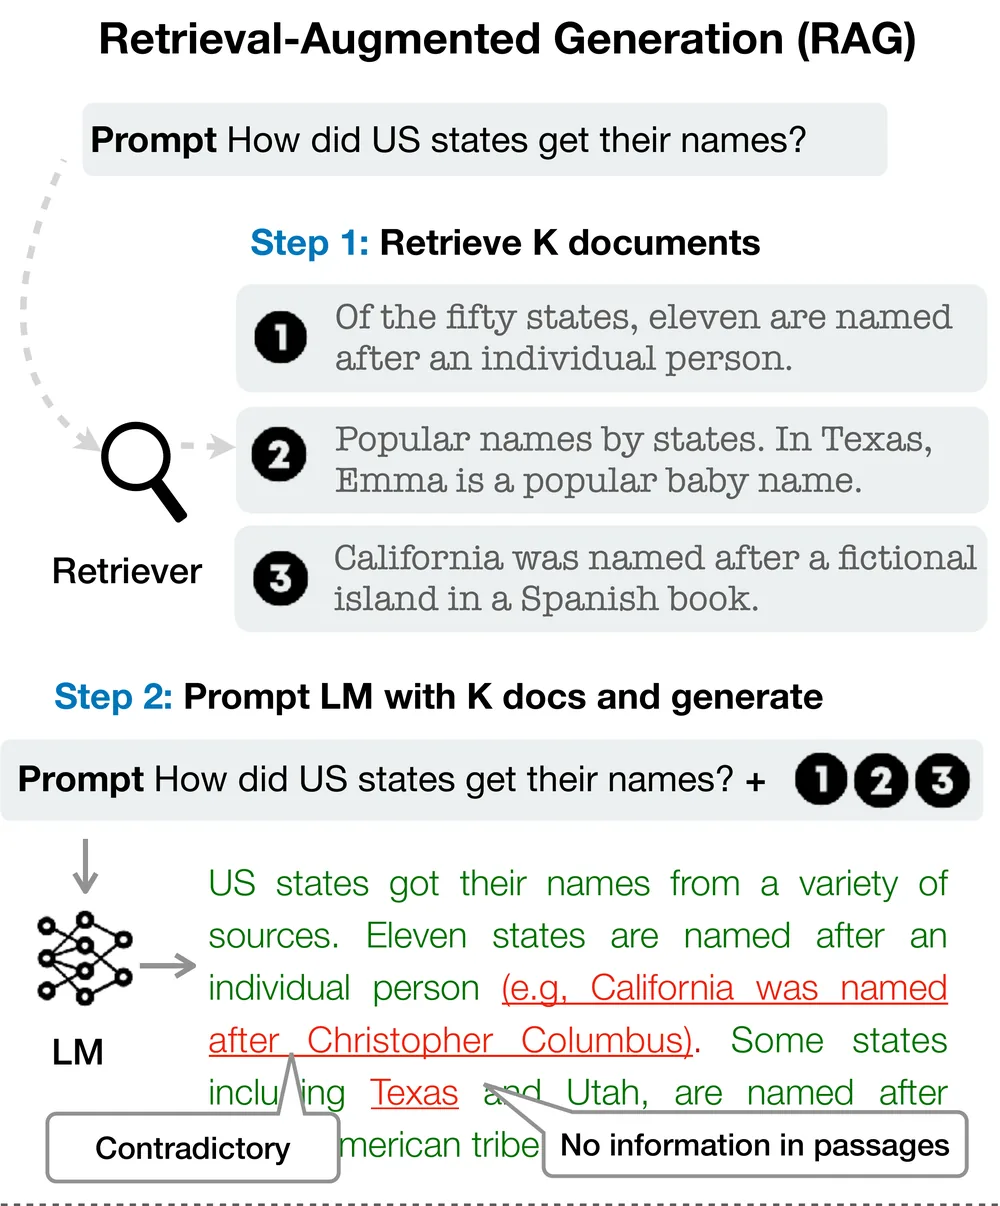
이미지: Asai 외, 「Self-RAG」 그림 1의 왼쪽 부분 (CC BY 4.0, 일부를 잘라 사용)
위 그림은 일반적인 RAG의 흐름을 보여 줘요. “미국 주들은 이름을 어떻게 얻었나?“라는 질문에 검색기가 문서 3개를 찾아요(1단계). 그다음 언어 모델이 질문과 문서를 함께 받아 답을 써요(2단계).
그런데 답이 이상해요. 3번 문서는 “캘리포니아는 스페인 책 속 가상의 섬에서 이름을 땄다”고 하는데, 모델은 “캘리포니아는 크리스토퍼 콜럼버스의 이름을 땄다”고 썼어요. 그림에는 모순(Contradictory)이라고 표시돼 있어요. “텍사스와 유타는 원주민 부족 이름을 땄다”는 부분은 찾아온 문서 어디에도 없는 내용이라 문서에 없는 정보로 표시됐고요. 2번 문서처럼 질문과 별 관계없는 내용(텍사스에서 인기 있는 아기 이름)이 섞여 들어온 것도 보여요.
이 그림을 실은 Self-RAG 논문은 바로 이 문제를 지적해요. 검색이 필요한지, 찾은 문서가 관련 있는지 따지지 않고 정해진 개수만큼 가져다 붙이면 오히려 도움이 안 되는 답이 나올 수 있다는 거예요. 핵심은 하나예요. RAG를 쓴다고 해서 AI가 틀리지 않는 건 아니에요.
실제로 만들어 보니 나온 7가지 실패 지점
앞에서 소개한 「Seven Failure Points」 논문은 연구, 교육, 생명과학 분야에서 RAG를 직접 만들어 본 사례 세 가지를 바탕으로 실패 지점 7개를 정리했어요. 논문 결론에는 문서 1만 5천 건과 질문 1천 개를 다룬 실험이라고 적혀 있어요. 다만 같은 논문의 사례 요약표에는 생명과학 사례의 문서 수가 4,017건으로 나와 있어서, 두 숫자가 정확히 무엇을 가리키는지는 논문만으로는 확인되지 않아요.
| 번호 | 실패 지점 | 무슨 일이 일어나나 |
|---|---|---|
| 1 | 내용이 없음 | 문서에 답이 없는데, “모르겠다” 대신 그럴듯한 답을 만든다 |
| 2 | 상위 결과에서 빠짐 | 답이 든 문서가 있지만 검색 순위가 낮아 상위 K개에 못 든다 |
| 3 | 맥락에 못 들어감 | 검색은 됐지만 정리 단계에서 잘려 모델에게 전달되지 않는다 |
| 4 | 추출 실패 | 답이 맥락 안에 있는데도 잡음이나 서로 다른 정보 때문에 모델이 못 뽑아낸다 |
| 5 | 형식 틀림 | 표나 목록으로 답하라는 지시를 무시한다 |
| 6 | 구체성 문제 | 답이 너무 뭉뚱그려졌거나 반대로 지나치게 세부적이다 |
| 7 | 불완전한 답 | 틀리진 않았지만 맥락에 있던 정보 일부를 빠뜨린다 |
1~3번은 검색 쪽 문제, 4~7번은 답을 쓰는 모델 쪽 문제로 나눠 보면 이해하기 쉬워요. 앞의 그림 속 오답은 4번 추출 실패에 가까워요. 답이 될 문서를 찾아 놓고도 모델이 그 내용을 제대로 쓰지 못했으니까요.
이 논문이 내린 결론 두 가지도 눈여겨볼 만해요. 첫째, RAG 시스템이 잘 작동하는지는 실제 운영해 봐야만 검증할 수 있어요. 어떤 질문이 들어올지 미리 다 알 수 없기 때문이에요. 둘째, 견고함은 처음부터 설계로 완성되는 게 아니라 운영하면서 점점 다듬어져요. 7번 같은 문제를 줄이려면 “문서 A, B, C의 요점이 뭐야?“처럼 한꺼번에 묻기보다 문서별로 따로 묻는 편이 낫다는 조언도 있어요.
성능을 좌우하는 부품들
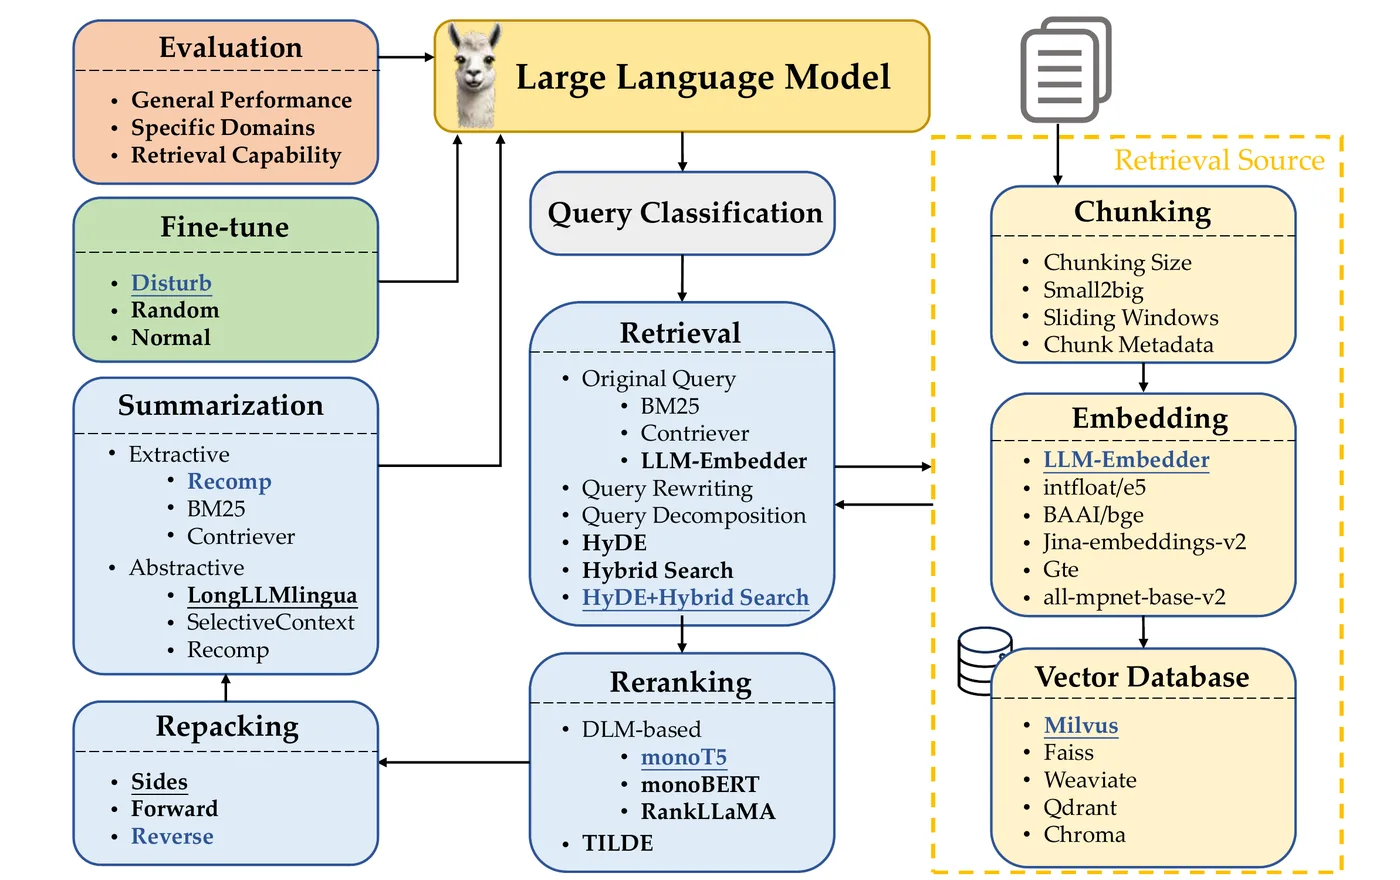
이미지: Wang 외, 「Searching for Best Practices in Retrieval-Augmented Generation」 그림 1 (CC BY 4.0)
RAG는 하나의 기술이라기보다 여러 부품을 이어 붙인 조립품이에요. 위 그림은 2024년 「Searching for Best Practices in RAG」 논문이 정리한 구성이에요. 질문 분류, 검색, 리랭킹, 문서 재배치(리패킹), 요약 단계가 있고, 각 단계마다 고를 수 있는 방법이 여러 개예요. 파란 글씨가 연구팀 실험에서 가장 좋았던 선택이에요.
이 논문의 실험 결과 중 일반 사용자도 참고할 만한 부분을 추리면 이래요.
- 검색이 필요 없는 질문은 거르는 게 이득이에요. 질문 분류 단계를 넣었더니 종합 점수가 0.428에서 0.443으로 오르고, 질문 하나 처리 시간은 16.41초에서 11.58초로 줄었어요.
- 가장 정확한 방법이 늘 정답은 아니에요. 가상의 답을 먼저 만들어 검색에 쓰는 HyDE와 키워드·의미 검색을 섞은 하이브리드 검색 조합이 RAG 점수 0.58로 가장 높았어요. 하지만 질문 하나에 11.71초가 걸려서, 연구팀은 속도를 생각하면 하이브리드 검색이나 기본 검색을 쓰라고 권했어요.
- 관련도 높은 문서를 질문 가까이에 두면 좋아요. 가장 관련 있는 문서를 질문 바로 앞에 오도록 거꾸로 배치하는 방식(Reverse)이 RAG 점수 0.560으로 가장 좋았어요.
다만 이 수치는 연구팀이 추가 학습한 Llama2-7B-Chat 모델과 연구팀이 고른 데이터셋으로 실험한 결과예요. 다른 모델이나 문서에서는 결과가 달라질 수 있으니, 정답보다는 “어디를 조정할 수 있는지 보여 주는 지도”로 읽는 게 좋아요.
RAG와 파인튜닝, 무엇이 다를까
새 지식을 AI에 넣는 또 다른 방법은 파인튜닝, 즉 모델을 추가로 학습시키는 거예요. 둘의 차이는 오픈북 시험과 시험 전 벼락치기에 빗댈 수 있어요.
| RAG | 파인튜닝 | |
|---|---|---|
| 지식이 있는 곳 | 바깥 문서 (필요할 때 찾아봄) | 모델 가중치 안 (학습으로 외움) |
| 정보 갱신 | 문서만 바꾸면 됨 | 다시 학습해야 함 |
| 출처 제시 | 찾아온 문서를 보여 줄 수 있음 | 어렵다 |
2023년 12월 공개된 「Fine-Tuning or Retrieval?」 논문은 두 방식을 직접 비교했어요. 지식이 많이 필요한 여러 과제에서 RAG가 비지도 파인튜닝보다 꾸준히 좋은 성적을 냈다고 해요. 모델이 학습 때 본 적 있는 지식이든 완전히 새로운 지식이든 마찬가지였어요. 연구팀은 LLM이 비지도 파인튜닝만으로는 새로운 사실을 익히기 어려워한다는 점도 짚었어요. 같은 사실을 여러 표현으로 바꿔 보여 주면 이 문제가 줄어들 수 있다고 했고요.
정리: RAG 서비스를 볼 때 확인할 것
RAG는 AI가 최신 정보나 내부 문서를 바탕으로 답하게 만드는 데 널리 쓰이는 방법이에요. 하지만 그림에서 봤듯 검색을 붙였다고 정답이 보장되지는 않아요. “RAG 기반” 서비스를 쓸 때는 이 세 가지를 확인해 보세요.
- 답에 근거 문서가 표시되나요? 출처를 보여 주는 게 RAG의 큰 장점이에요. 링크가 있다면 한 번은 눌러서 실제로 그 내용이 있는지 확인하세요.
- 문서에 없는 질문에 “모른다”고 하나요? 그렇지 않다면 1번 실패 지점(내용 없음)에 취약한 거예요.
- 여러 문서를 한꺼번에 요약하게 하면 빠지는 내용이 없나요? 중요한 일이라면 문서별로 나눠 묻는 편이 안전해요.