12GB 그래픽카드가 있다면 14B 모델까지는 Q4_K_M으로 들어가요. 8GB면 8B 언저리, 24GB면 32B까지예요. 대화 길이를 8K 토큰 정도로 잡았을 때 이야기고, 컨텍스트를 늘리면 이 경계가 금방 한 칸씩 내려와요.
이 숫자는 감으로 정한 게 아니라 계산 하나로 나와요. 필요한 VRAM은 가중치, KV 캐시, 여유분 세 덩어리의 합이거든요. 모델 페이지의 config.json에서 숫자 네 개만 꺼내면 누구나 같은 계산을 할 수 있어요. 아래 예시는 크기가 고르게 나와 있는 Qwen3 시리즈의 실제 설정값으로 계산했어요.
가중치: 파라미터 수 × 비트 수
가장 큰 덩어리는 모델 가중치예요. 파라미터 하나를 몇 비트로 저장하느냐에 파라미터 수를 곱하면 끝이에요. llama.cpp의 quantize 문서에는 Llama 3.1 8B를 단계별로 양자화했을 때의 실제 비트 수가 나와 있어요. F16은 16.0, Q8_0은 8.50, Q6_K는 6.56, Q5_K_M은 5.70, Q4_K_M은 4.89비트예요.
이걸 바이트로 바꾸면 파라미터 10억 개(1B)당 F16은 2.0GB, Q8_0은 약 1.06GB, Q6_K는 0.82GB, Q4_K_M은 0.61GB예요. 그러니까 Q4_K_M 모델 크기는 “몇 B × 0.6GB”로 어림하면 거의 맞아요. 이 문서 표에서 Llama 3.1 8B의 Q4_K_M이 실제로 4.58GiB였는데, 같은 식에 8.03B를 넣으면 4.58GiB가 나와요.
| 모델 (파라미터) | F16 | Q8_0 | Q6_K | Q4_K_M |
|---|---|---|---|---|
| Qwen3-4B (4.0B) | 7.5 | 4.0 | 3.1 | 2.3 |
| Qwen3-8B (8.2B) | 15.3 | 8.1 | 6.3 | 4.7 |
| Qwen3-14B (14.8B) | 27.6 | 14.7 | 11.3 | 8.4 |
| Qwen3-30B-A3B (30.5B) | 56.8 | 30.2 | 23.3 | 17.4 |
| Qwen3-32B (32.8B) | 61.1 | 32.5 | 25.1 | 18.7 |
단위 GiB, 파라미터 수는 각 모델 카드 기준, QuestBrief 계산
한 가지 단서가 있어요. 양자화 단계마다 어떤 층을 더 정밀하게 남기는지가 정해져 있어서, 실제 비트 수는 모델 구조에 따라 조금씩 달라져요. 위 표는 Llama 3.1 8B에서 잰 비트 수를 그대로 쓴 추정치예요. 받으려는 GGUF 파일 크기가 다운로드 페이지에 나와 있다면 그 숫자가 더 정확해요.
KV 캐시: 모델 크기와 따로 노는 덩어리
두 번째 덩어리는 KV 캐시예요. 모델이 앞에서 읽은 토큰을 기억해 두는 공간이라 대화가 길어질수록 커지죠. 공식과 원리는 양자화 글에서 자세히 다뤘으니, 여기서는 계산에 쓰는 숫자만 짚을게요.
토큰 하나당 KV 캐시 = 2 × 층 수 × KV 헤드 수 × 헤드 차원 × 2바이트 (F16 기준)
config.json에서 num_hidden_layers, num_key_value_heads, head_dim 세 값을 찾으면 돼요. Qwen3-8B는 36층, KV 헤드 8개, 헤드 차원 128이라 토큰당 144KiB, 8K 토큰이면 1.1GiB예요.
여기서 많이 하는 실수가 하나 있어요. 헤드 차원을 hidden_size ÷ num_attention_heads로 구하는 거예요. 양자화 글에서 계산한 Llama 3 8B는 이렇게 해도 맞는데, Qwen3-32B는 hidden_size가 5,120이고 어텐션 헤드가 64개라 나눠 보면 80이 나와요. 그런데 config.json에 적힌 head_dim은 128이에요. 80으로 계산하면 KV 캐시를 37.5% 적게 잡게 되죠. head_dim 값이 따로 있으면 그걸 써야 해요.
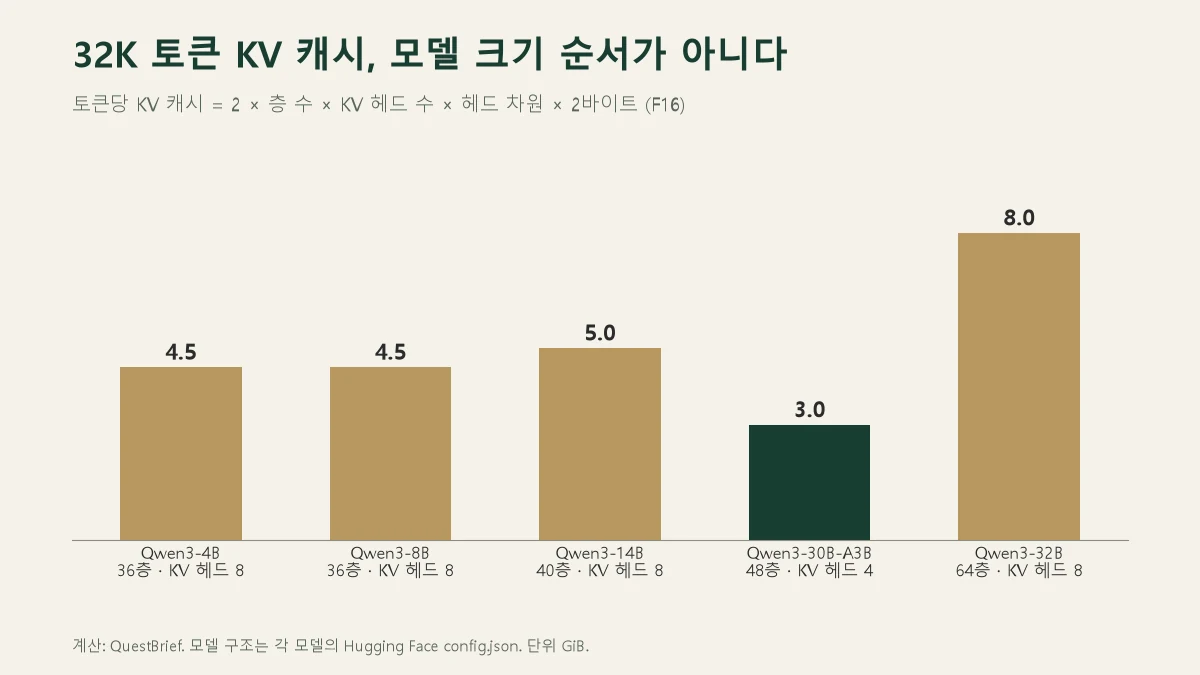
그래프: QuestBrief 계산
그래프를 보면 KV 캐시는 모델 크기 순서대로 커지지 않아요. 4B와 8B는 층 수와 KV 헤드 수가 같아서 KV 캐시도 똑같고, 14B도 고작 11% 더 커요. 32B는 층이 64개라 확 커지고요. 제일 의외인 건 30B-A3B예요. 파라미터는 30B인데 KV 헤드가 4개뿐이라 32K 토큰에 3GiB, 4B보다도 작아요.
여유분: llama.cpp는 1GiB를 남긴다
마지막 덩어리는 연산용 버퍼 같은 추가 메모리예요. 이건 모델과 설정에 따라 달라서 공식으로 딱 떨어지진 않아요. 대신 기준으로 삼을 만한 숫자가 있어요. llama.cpp 서버 문서를 보면 --fit 옵션이 기본으로 켜져 있고, 설정하지 않은 값들을 장치 메모리에 맞게 자동으로 조정해요. 이때 장치마다 남겨 두는 여유가 기본 1,024MiB예요. 이 글의 계산도 여기에 맞춰 1GiB를 더했어요.
그래픽카드별로 따져 보면
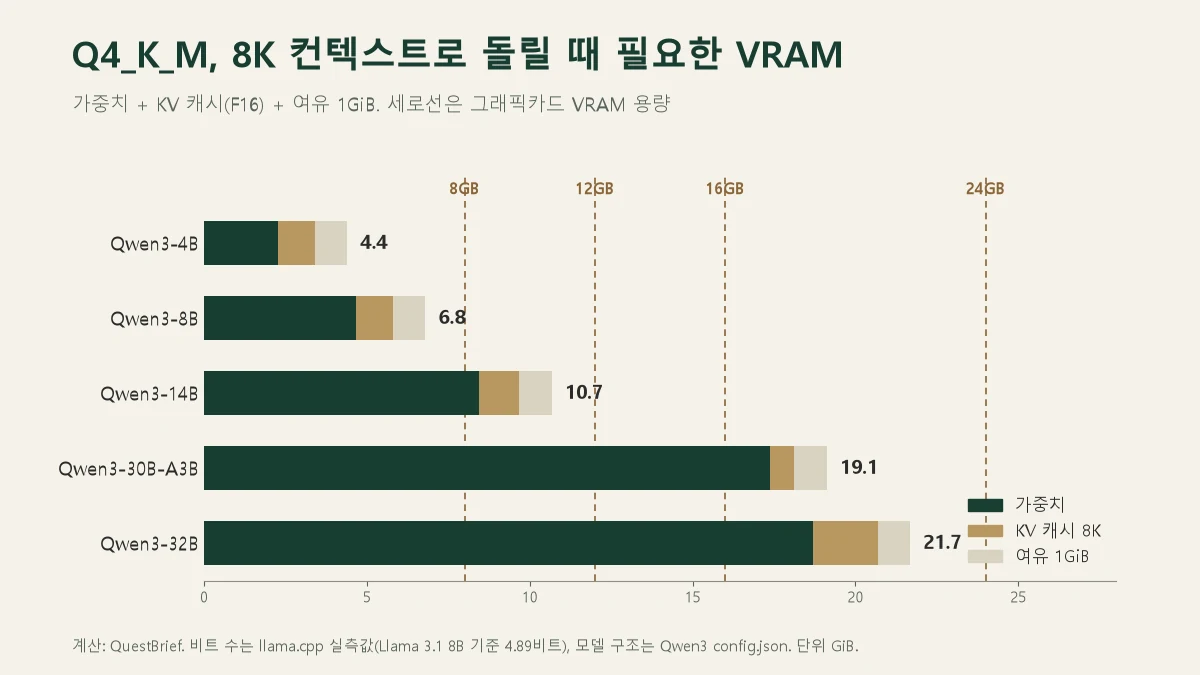
그래프: QuestBrief 계산
세 덩어리를 더하면 위 그래프가 나와요. 전부 Q4_K_M, 컨텍스트 8K 기준이에요.
8GB 카드는 8B가 6.8GiB로 들어가요. 여기서 Q6_K로 올리면 가중치만 6.3GiB라 합계가 8.4GiB가 되니 넘쳐요. 8GB에서는 8B Q4_K_M이 상한이라고 보면 편해요. 컨텍스트를 32K로 늘려도 KV 캐시가 4.5GiB라 합계 10.2GiB, 이것도 안 들어가요.
12GB 카드는 14B Q4_K_M이 10.7GiB로 들어가요. 남는 게 1GiB 남짓이라 컨텍스트를 크게 늘리긴 어렵고요. 8B를 쓴다면 Q8_0(8.1GiB)에 8K 컨텍스트까지 넉넉히 올라가요.
16GB 카드부터는 고를 게 생겨요. 14B를 Q6_K로 올려도 11.3 + 1.25 + 1 = 13.6GiB라 들어가거든요. 같은 메모리로 14B Q4_K_M에 32K 컨텍스트(8.4 + 5.0 + 1 = 14.4GiB)를 쓸 수도 있어요. 품질과 대화 길이 중 하나를 고르는 셈이에요.
24GB 카드는 32B Q4_K_M이 21.7GiB로 들어가요. 다만 컨텍스트를 32K로 늘리면 KV 캐시만 8GiB라 27.7GiB가 돼서 넘쳐요. 32B를 긴 문서 작업에 쓰려면 KV 캐시를 q8_0으로 줄이거나(llama.cpp의 -ctk, -ctv 옵션) 컨텍스트를 줄여야 해요. 같은 24GB에서 30B-A3B는 32K 컨텍스트로도 17.4 + 3.0 + 1 = 21.4GiB라 여유 있게 들어가요.
MoE 모델은 “3B”를 믿으면 안 돼요
Qwen3-30B-A3B 같은 이름의 A3B는 토큰 하나를 처리할 때 실제로 쓰는 파라미터가 3B라는 뜻이에요. 모델 카드에는 전체 30.5B 중 3.3B가 활성화된다고 적혀 있고, 전문가(expert) 128개 중 8개만 골라 써요.
그래서 3B 모델처럼 가볍겠다고 생각하기 쉬운데, 메모리는 그렇지 않아요. Hugging Face의 MoE 설명 글은 MoE가 추론 때 일부 파라미터만 쓰는 대신 “모든 파라미터를 메모리에 올려야 해서 메모리 요구량이 높다”고 정리해요. 계산량은 활성 파라미터를 따라가고, 메모리는 전체 파라미터를 따라가는 거죠. 위 그래프에서 30B-A3B가 32B 바로 옆에 있는 이유예요.
그 대신 MoE에는 VRAM이 모자랄 때 쓸 수 있는 방법이 하나 더 있어요. llama.cpp에는 전문가 가중치만 CPU 쪽 메모리에 두는 --cpu-moe 옵션과, 앞쪽 N개 층의 전문가만 CPU에 두는 --n-cpu-moe N 옵션이 있어요. 매번 쓰이는 공용 부분과 KV 캐시는 GPU에 두고, 토큰마다 일부만 불려 나오는 전문가를 시스템 메모리로 빼는 방식이에요. 이렇게 하면 속도가 얼마나 떨어지는지는 이번에 본 자료에 실측이 없어서 여기서는 말하지 않을게요.
GB와 GiB가 섞여 있다는 것도
계산하다 보면 숫자가 미묘하게 안 맞을 때가 있어요. 단위가 섞여 있어서 그래요. llama.cpp 문서의 Llama 3.1 표만 봐도 한쪽은 “4.9 GB”, 다른 쪽은 “4.58 GiB”로 같은 파일을 다르게 적어요. 1GiB는 2의 30제곱 바이트라 1GB(10억 바이트)보다 7% 남짓 커요. 이 글의 표와 그래프는 모두 GiB로 통일했어요. 다운로드 페이지의 파일 크기가 GB로 적혀 있다면 0.93을 곱하면 GiB가 돼요.
새 모델이 나와서 내 카드에 들어갈지 궁금하다면, 모델 페이지에서 config.json을 열고 num_hidden_layers, num_key_value_heads, head_dim을 찾은 다음 모델 카드의 파라미터 수를 확인해 보세요. 네 숫자와 위 공식 두 줄이면 다운로드 버튼을 누르기 전에 답이 나와요.