로컬 LLM을 받으러 Hugging Face에 들어가면 같은 모델 이름 뒤에 파일이 열 개 넘게 붙어 있어요. Q8_0, Q6_K, Q5_K_M, Q4_K_M, IQ4_XS, Q3_K_S… 뭘 받아야 할지 몰라서 일단 제일 많이 보이는 Q4_K_M을 고르게 되죠. 틀린 선택은 아닌데, 왜 그게 무난한지 알고 고르면 내 그래픽카드에서 한 단계 큰 모델을 돌릴 수 있을 때도 있어요.
이 글은 llama.cpp 저장소에 공개된 실측 표를 바탕으로 이름 읽는 법, 단계별로 잃는 품질, 실제로 필요한 메모리를 차례로 짚어요. 그래프 두 장은 그 표의 숫자로 직접 계산해 만들었어요.
양자화는 숫자를 덜 정밀하게 저장하는 일
LLM은 결국 수십억 개의 숫자(가중치) 묶음이에요. 학습할 때는 보통 이 숫자 하나를 16비트나 32비트로 저장하는데, llama.cpp의 quantize 문서는 양자화를 “32비트 실수를 4비트 정수 같은 형태로 정밀도를 낮추는 일”이라고 설명해요. 파일이 작아지고 추론이 빨라질 수 있는 대신 정확도를 조금 잃는다는 단서도 함께 달려 있고요.
크기 차이는 꽤 극적이에요. 같은 문서의 표를 보면 Llama 3.1 8B는 원본 32.1GB가 Q4_K_M으로 4.9GB가 되고, 70B는 280.9GB가 43.1GB가 돼요. 70B도 원본이면 서버급 장비가 필요하지만, Q4_K_M이면 메모리를 넉넉히 꽂은 데스크톱에서 돌려 볼 수 있는 크기가 되는 셈이죠.
Q4_K_M을 한 글자씩 읽어 보면
이름은 생각보다 규칙적이에요.
- Q 뒤의 숫자는 가중치 하나에 쓰는 기본 비트 수예요. Q8은 8비트, Q4는 4비트.
- K는 2023년 6월 llama.cpp에 들어온 k-quants 방식이라는 뜻이에요. 가중치를 작은 블록으로 나누고, 블록마다 따로 배율(scale)을 저장해서 오차를 줄여요.
- S·M·L 접미사는 같은 방식 안에서 어떤 층을 더 정밀하게 남기느냐를 나타내요. 클수록 파일이 커지고 품질이 조금 좋아져요.
Hugging Face의 GGUF 문서에 따르면 Q4_K는 32개짜리 블록 8개를 묶은 슈퍼블록 구조이고, 배율과 최솟값을 6비트로 따로 저장해서 가중치 하나당 실제로는 4.5비트를 써요. 숫자는 “4”인데 진짜 비용은 그보다 조금 큰 거죠.
M이 붙으면 더 커져요. k-quants를 처음 제안한 PR #1684의 설명으로는 Q4_K_M이 attention.wv와 feed_forward.w2 텐서의 절반을 6비트(Q6_K)로 남기고 나머지만 Q4_K로 줄여요. 그래서 llama.cpp가 Llama 3.1 8B로 측정한 실제 비트 수는 Q4_K_S가 4.67, Q4_K_M이 4.89예요. 다만 이 PR 설명은 2023년 기준이에요. 모든 텐서를 Q4_K로 만든다던 Q4_K_S가 4.5가 아니라 4.67로 측정되는 걸 보면, 그 뒤로 세부 구성이 바뀌었을 가능성이 있어요.
나머지 이름도 짧게 정리할게요. 이름이 IQ로 시작하는 파일(IQ4_XS, IQ3_M 등)은 중요도 행렬(importance matrix)을 써서 어떤 가중치를 더 정밀하게 지킬지 정하는 방식이에요. Q4_0, Q5_1 같은 이름은 k-quants 이전의 방식인데, Hugging Face 문서는 이걸 “오늘날 널리 쓰이지 않는 레거시 방식”으로 분류해요.
단계를 내릴 때마다 얼마나 잃을까
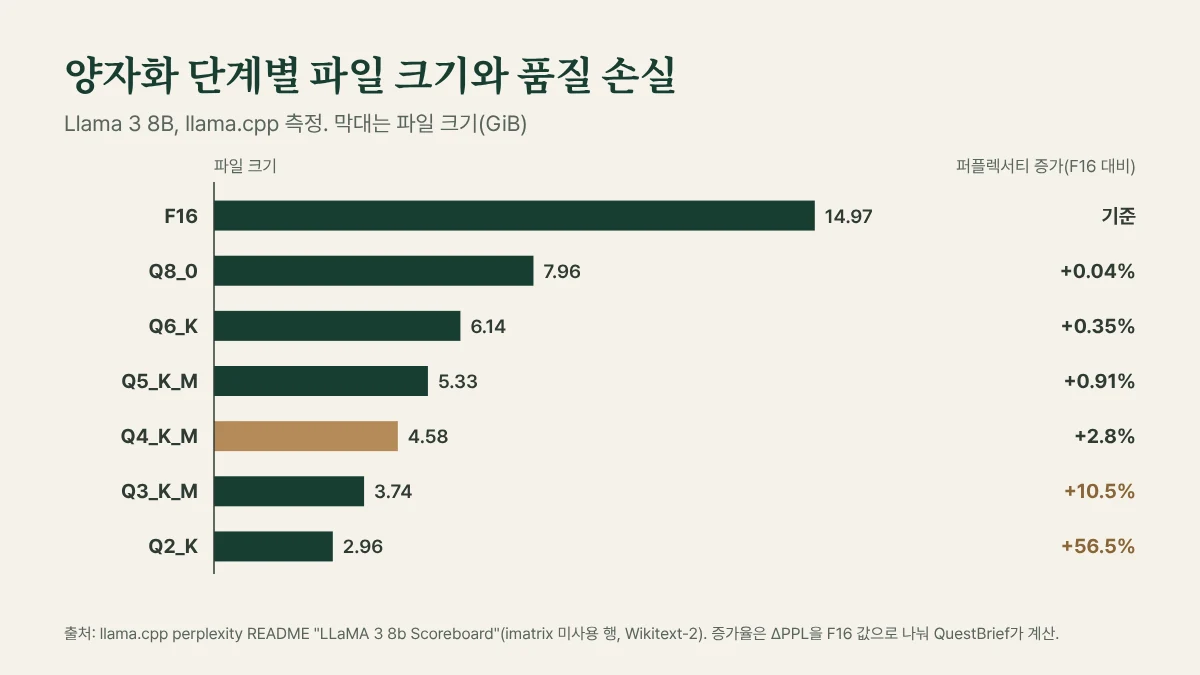
그래프: llama.cpp perplexity README 수치로 QuestBrief 계산
llama.cpp perplexity 문서에는 Llama 3 8B를 단계별로 양자화해 품질을 잰 표가 있어요. 퍼플렉서티(PPL)는 모델이 다음 단어를 얼마나 잘 맞히는지 나타내는 값이고 낮을수록 좋아요. 위 그래프의 오른쪽 숫자는 표의 ΔPPL을 F16 값으로 나눠, 원본보다 퍼플렉서티가 몇 % 나빠졌는지로 바꾼 거예요.
읽는 법은 이래요. Q8_0은 파일이 절반인데 손실이 0.04%라 사실상 원본과 같아요. Q6_K와 Q5_K_M까지도 1% 미만이고요. Q4_K_M에서 2.8%로 처음 눈에 띄게 오르고, Q3_K_M은 10.5%, Q2_K는 56.5%로 확 무너져요. 크기는 Q4_K_M에서 Q2_K까지 1.6GiB밖에 안 줄었는데 품질은 스무 배 넘게 더 잃는 셈이에요.
같은 문서에는 “양자화된 모델이 원본과 같은 단어를 1순위로 고른 비율”도 있어요. Q8_0은 97.7%, Q6_K는 96.0%, Q4_K_M은 91.9%, Q2_K는 71.1%예요. Q4_K_M이면 열 번 중 아홉 번 남짓은 원본과 같은 단어를 고른다는 뜻이라, 체감이 어떨지 감을 잡는 데 이쪽이 더 직관적일 수도 있어요.
이 표를 볼 때 알아 둘 점도 있어요. 문서 스스로 퍼플렉서티는 모델끼리 비교하는 숫자가 아니라 같은 모델의 양자화 손실을 보는 용도라고 못 박아 둬요. 측정은 Wikitext-2 문장으로 했고, 대화나 코딩 품질을 직접 잰 건 아니에요. 그리고 흥미로운 비교가 하나 있는데, 같은 Q4_K_M이라도 Llama 2 7B는 퍼플렉서티가 1.4% 늘었지만 Llama 3 8B는 2.8% 늘었어요. 문서가 이유를 따로 설명하진 않지만, 같은 단계라도 모델에 따라 잃는 정도가 두 배까지 차이 난다는 건 분명해요. 새 모델을 받을 때 예전 모델에서 쓰던 단계를 그대로 고르기보다 한 단계 위도 비교해 볼 만한 이유예요.
중요도 행렬(imatrix)을 쓰면 같은 크기에서 손실이 줄어요. 같은 표에서 Q4_K_M의 퍼플렉서티 증가량(ΔPPL)은 imatrix 없이 0.175, 있으면 0.151이었죠. 다운로드 페이지에 “imatrix”라고 적힌 파일이 있으면 그쪽을 고르는 게 손해 볼 일이 없어요.
내 GPU에 들어갈까: 모델 크기만 보면 틀리는 이유
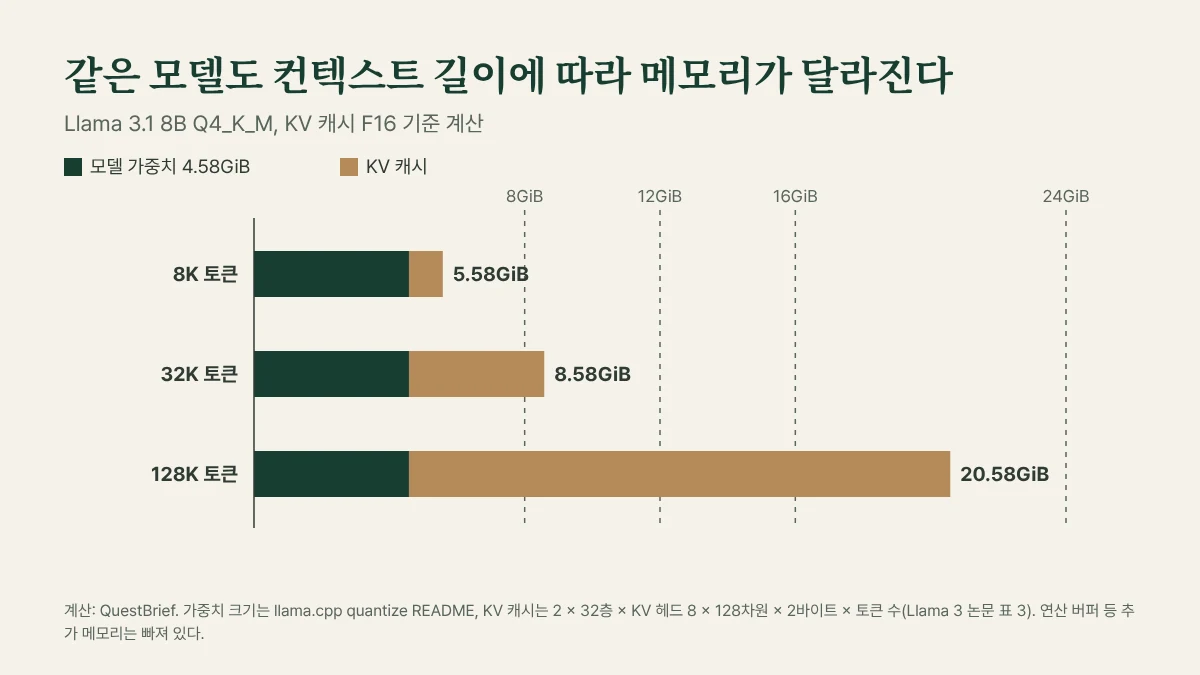
그래프: QuestBrief 계산
파일 크기가 4.6GiB면 8GB 그래픽카드에 넉넉히 들어갈 것 같지만, 실제로는 KV 캐시라는 게 따로 메모리를 먹어요. 모델이 앞에서 읽은 토큰을 기억해 두는 공간인데, 대화가 길어질수록 커져요.
KV 캐시 크기는 모델 구조만 알면 계산할 수 있어요. 직접 계산해 보면 이래요.
토큰 하나당 KV 캐시 = 2(K와 V) × 층 수 × KV 헤드 수 × 헤드 차원 × 2바이트(F16)
Llama 3 논문의 표 3을 보면 8B 모델은 32층, 모델 차원 4,096, 어텐션 헤드 32개, KV 헤드 8개예요. 헤드 차원은 모델 차원을 헤드 수로 나눈 4,096 ÷ 32 = 128이니까, 토큰 하나에 2 × 32 × 8 × 128 × 2 = 131,072바이트, 즉 128KiB예요. 8K(8,192) 토큰이면 딱 1GiB, 32K면 4GiB, 논문이 지원한다고 밝힌 최대치 128K까지 채우면 16GiB가 돼요.
그래서 같은 Q4_K_M이라도 8K 대화에서는 5.6GiB 정도라 8GB 카드에 들어가지만, 128K를 다 쓰면 20GiB를 넘어서 24GB 카드도 빠듯해져요. 이 계산에는 연산용 버퍼 같은 추가 메모리가 빠져 있어서 실제 사용량은 조금 더 나와요.
70B로 가면 계산이 더 무거워져요. 같은 표 기준으로 80층에 KV 헤드 8개라 토큰당 320KiB이고, 8K 토큰만 해도 2.5GiB예요. 가중치 43.1GB에 이게 더해지니 24GB 카드 한 장으로는 GPU에 다 올릴 수 없어요.
메모리가 모자랄 때 쓸 수 있는 손잡이
llama.cpp 서버 문서에는 메모리를 조절하는 옵션이 정리돼 있어요. 자주 쓰는 건 세 가지예요.
-c(--ctx-size): 컨텍스트 길이를 정해요. 기본값 0은 모델 설정값을 그대로 쓰는데, 긴 컨텍스트를 지원하는 모델이면 그만큼 KV 캐시를 잡아 버릴 수 있어서 직접 8192 정도로 줄여 두는 게 안전해요.-ctk,-ctv: KV 캐시의 자료형이에요. 기본은 f16이고 q8_0, q4_0 등으로 바꿀 수 있어요. q8_0은 값 하나에 8비트 남짓을 쓰니 f16의 대략 절반 크기가 돼요.-ngl(--n-gpu-layers): GPU에 올릴 층 수예요. 다 안 들어가면 일부만 GPU에 두고 나머지는 시스템 메모리에서 돌릴 수 있어요. 대신 그만큼 느려져요.
KV 캐시를 양자화했을 때 품질이 얼마나 떨어지는지는 이번에 본 자료에 실측이 없어서, 여기서는 크기만 말할게요.
Q4_K_M에서 시작해 위아래로 움직이기
고르는 순서는 단순해요. 먼저 내 VRAM에서 “가중치 + 쓰려는 컨텍스트의 KV 캐시 + 여유 1GiB 정도”가 들어가는 가장 큰 모델을 찾고, 그 모델의 Q4_K_M에서 시작해요. 메모리가 남으면 Q5_K_M이나 Q6_K로 올리고, 모자라면 컨텍스트를 줄이거나 KV 캐시를 q8_0으로 바꿔 보는 거죠.
반대로 Q3 아래로 내려가는 건 신중하게 하는 게 좋아요. 위 표에서 8B 모델은 Q3_K_M부터 손실이 10%를 넘었거든요. Q2까지 깎아야 겨우 들어가는 모델이라면, 크기가 한 단계 작은 모델의 Q4_K_M도 함께 받아 내 질문으로 직접 비교해 보길 권해요. 이번 자료는 같은 모델 안에서만 잰 거라, 큰 모델의 Q2와 작은 모델의 Q4 중 어느 쪽이 낫다고는 단정할 수 없거든요.