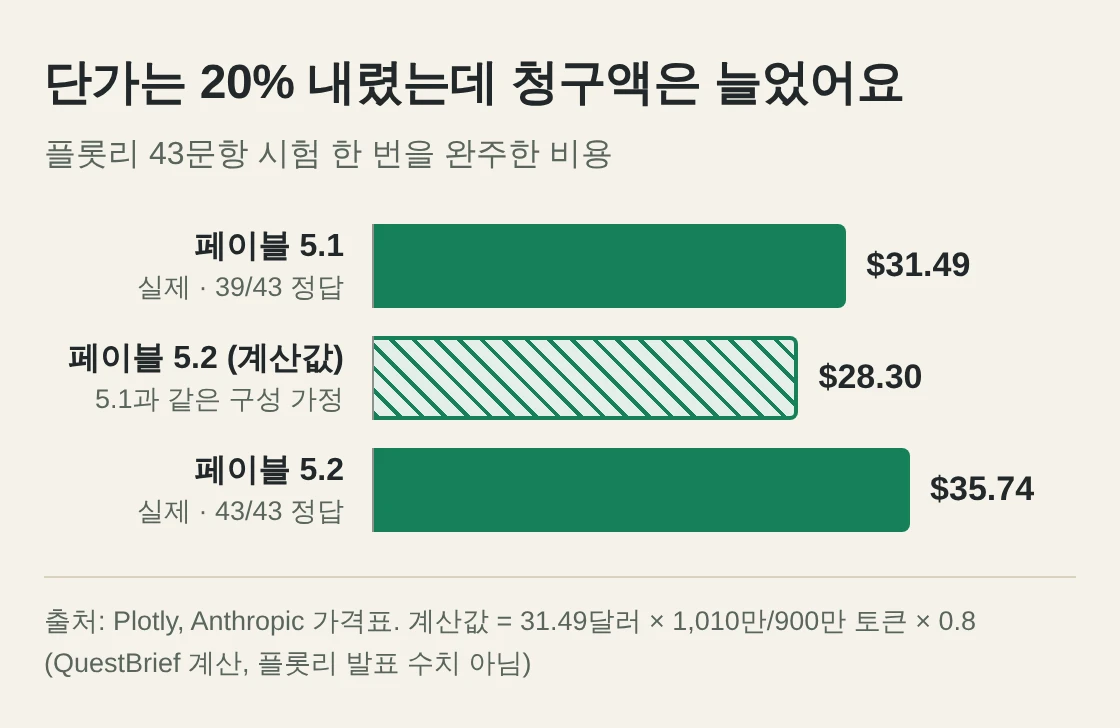
정답 하나에 0.81달러. 페이블 5.1이 플롯리(Plotly)의 데이터 분석 시험에서 낸 성적을 비용으로 나눠 보면 이 숫자가 나와요. 31.49달러를 써서 43문제 중 39개를 맞혔거든요. 같은 시험에서 페이블 5.2는 35.74달러로 43개를 전부 맞혔고, 정답 하나당 0.83달러예요. 단가를 20% 내린 새 모델인데 정답 하나 값은 오히려 3% 올랐다는 계산이죠.
앤트로픽은 11월 9일 클로드 페이블 5.2(Claude Fable 5.2)를 내놓으면서 가격을 100만 토큰당 입력 8달러, 출력 40달러로 정했어요. 공식 가격표에 남아 있는 페이블 5.1은 입력 10달러, 출력 50달러였으니 정확히 20% 인하예요. 그런데 플롯리 실측에서 총액은 13.5% 늘었어요. 단가표와 청구서가 왜 따로 노는지, 플롯리가 공개한 항목별 금액과 앤트로픽 가격표를 맞대 보면 꽤 많은 게 보여요.
20% 인하는 정말 모든 항목에 적용됐어요
먼저 의심부터 풀어 둘게요. 혹시 눈에 보이는 입출력 단가만 내리고 다른 항목은 그대로 둔 건 아닐까? 앤트로픽 프롬프트 캐싱 문서의 가격표를 보면 그렇지 않아요.
| 항목 (100만 토큰당) | 페이블 5.1 | 페이블 5.2 | 오퍼스 5.5 |
|---|---|---|---|
| 기본 입력 | 10달러 | 8달러 | 4달러 |
| 캐시 쓰기 (5분) | 12.50달러 | 10달러 | 5달러 |
| 캐시 읽기 | 0.25달러 | 0.20달러 | 0.20달러 |
| 출력 | 50달러 | 40달러 | 20달러 |
입력, 캐시 쓰기, 캐시 읽기, 출력이 모두 5.1의 80%예요. 그러니 같은 토큰을 같은 비율로 썼다면 청구액도 정확히 20% 줄어야 해요. 플롯리 기준으로 계산해 보면 5.1이 쓴 900만 토큰이 1,010만 토큰으로 늘어난 것까지 감안해도 약 28.3달러가 나와야 하거든요(31.49달러 × 1,010만/900만 × 0.8). 실제 청구액 35.74달러와는 7달러 넘게 차이가 나요. 이 차이는 단가가 아니라 토큰의 종류에서 생겼다고 봐야 해요.
토큰의 4분의 3이 청구서의 4%였어요
플롯리는 5.2의 청구서를 이렇게 나눠 공개했어요. 캐시 쓰기 210만 토큰에 약 21달러, 출력 약 13달러, 캐시 읽기 약 1.50달러. 여기에 위 가격표를 대입하면 토큰 수를 거꾸로 추정할 수 있어요(플롯리 금액이 “약” 단위라 대략적인 값이에요).
캐시 읽기 1.50달러를 0.20달러로 나누면 약 750만 토큰이에요. 전체 1,010만 토큰의 4분의 3쯤 되는 양인데, 청구액에서는 4%밖에 차지하지 않아요. 반대로 캐시 쓰기 210만 토큰은 전체 토큰의 21% 정도지만 청구액의 59%를 가져갔고요. 출력은 13달러를 40달러로 나눈 약 33만 토큰, 토큰 수로는 3%인데 금액으로는 36%예요. 캐시를 거치지 않은 일반 입력은 남은 0.24달러, 3만 토큰 정도로 사실상 없는 셈이었어요.
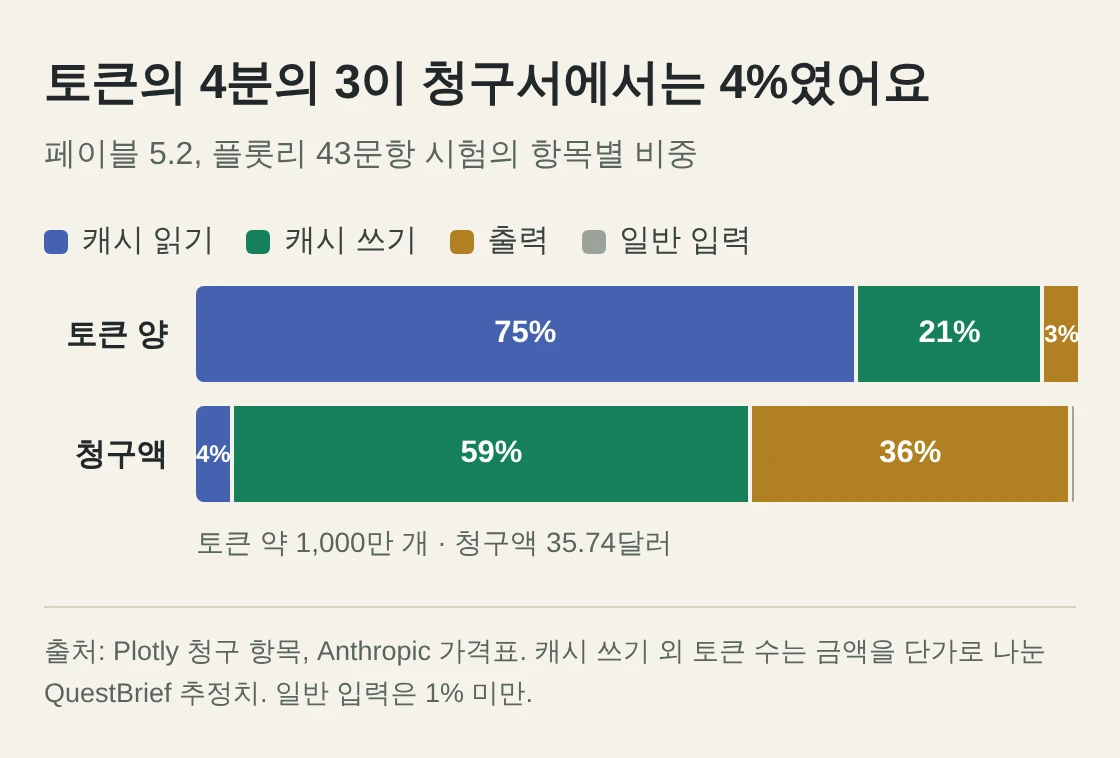
그러니 이 시험에서 입력 단가 인하는 거의 의미가 없었어요. 청구서를 움직인 건 캐시에 새로 쓰는 양과 모델이 내놓는 출력의 양이었죠. 5.1이 같은 시험에서 이 두 항목을 얼마나 썼는지는 플롯리가 공개하지 않았어요. 다만 앞의 계산대로라면 5.1은 토큰을 덜 썼을 뿐 아니라 비싼 종류의 토큰을 더 적게 썼다는 뜻이 돼요.
다만 이 비중은 플롯리 시험 하나의 결과예요. 같은 시스템 프롬프트를 오래 재사용하는 작업이라면 캐시 읽기 비중이 커지고, 그쪽은 페이블 계열이 기본 입력의 0.025배라 아주 싸요. 1시간짜리 캐시를 쓰면 쓰기 단가가 100만 토큰당 16달러로 올라간다는 점도 같이 봐 둘 만하고요.
내 청구서에서 확인할 네 칸
결국 “20% 인하가 내 청구서에도 오느냐”는 질문의 답은 내 작업의 토큰 구성에 달려 있어요. 이건 직접 확인할 수 있어요. 앤트로픽 API 응답의 사용량(usage) 항목에는 input_tokens, cache_creation_input_tokens(캐시 쓰기), cache_read_input_tokens(캐시 읽기), output_tokens가 따로 찍히거든요.
지금 쓰는 모델로 대표 작업 몇 건을 돌려 이 네 숫자를 모아 두고, 페이블 5.2에서도 같은 작업을 돌려 비교하면 돼요. 네 칸에 위 가격표를 곱하면 금액이 나와요. 모든 단가가 80%가 됐으니, 5.2가 같은 구성으로 토큰을 25% 넘게 더 쓰지 않는 한 청구액은 줄어요. 플롯리 시험에서는 비싼 칸의 토큰이 그 이상 늘었던 거고요.
코딩 작업에서는 계산이 반대로 나와요
여기까지 보면 페이블 5.2가 비싼 모델처럼 보이는데, 코딩 쪽 자료는 결이 달라요. 오픈소스 메인테이너가 모델의 코드 변경을 머지할지를 보는 프론티어코드 2.0(FrontierCode 2.0)에서 앤트로픽은 페이블 5.2가 High 설정으로 45.3%를 받아 오퍼스 5.5의 최고점(45.5%)과 거의 같고, 작업당 비용은 대략 절반이라고 밝혔어요. 최고 설정인 Xhigh에서는 49.1%로, 앤트로픽이 시험한 공개 모델 중 가장 높았고요.
위 가격표로 보면 이 주장은 꽤 강한 말이에요. 페이블 5.2의 입력·출력 단가는 오퍼스 5.5의 정확히 두 배거든요. 단가가 두 배인데 작업당 비용이 절반이라면, 같은 토큰 구성 기준으로 청구되는 토큰이 오퍼스의 4분의 1 정도라는 계산이 나와요. 플롯리 시험에서 5.2가 5.1보다 토큰을 더 쓴 것과는 정반대 모습이죠.
어느 쪽이 내 작업에 맞을지는 아직 알 수 없어요. 앤트로픽의 “절반”은 오퍼스 5.5와 비교한 자사 측정이고, 플롯리의 “더 비쌌다”는 페이블 5.1과 비교한 결과예요. 페이블 5.2와 오퍼스 5.5를 같은 실무 작업에 넣고 청구액을 나란히 공개한 독립 측정은 이번에 확인한 자료 중에는 없었어요. 앤트로픽 스스로도 대부분의 작업은 오퍼스 5.5(“가장 강력한 데일리 드라이버”)에서 시작하라고 권하고, 페이블 5.2는 하위 모델이 막힐 때 조언하는 역할(Advisor)이나 작업을 나눠 맡기는 역할(Orchestrator)로 소개했어요.
돈보다 먼저 체감할 건 시간
스프링 프롬프트(Spring Prompt)의 실측은 비용 말고 시간 쪽을 보여 줘요. 설문 데이터를 분석하는 서베이벤치(SurveyBench)에서 페이블 5.2는 과제당 337초와 1.51달러를 썼어요. GPT-6.1 Sol은 222초에 0.14달러였고요. 나눠 보면 시간은 1.5배인데 비용은 10.8배예요. 기다림보다 비용 격차가 훨씬 커요. 대신 점수는 1,683점으로 17개 모델 중 1위였고, 2위 뮤즈 원더(1,485점)와도 198점 차이였어요.
생각(thinking) 기능을 끌 수 없다는 점도 대화형으로 쓸 때 부담이에요. 스프링 프롬프트에 따르면 창의 코딩 프롬프트 8개에서 기본 설정은 128,000토큰 출력 한도를 생각에 다 쓰고 답을 내지 못했고, effort를 낮춘 뒤에야 끝났어요. 체스로 반응 속도를 보는 불릿벤치(BulletBench)에서는 한 판에 10초를 주는 대국에서 첫 네 판을 시간패해 탈락했고, 3분에 수당 2초를 더하는 대국에서도 8판 중 4판만 이기고 나머지는 시간패였어요. 앤트로픽의 패스트 모드는 입력 16달러, 출력 80달러로 단가가 두 배인 대신 생성 속도를 최대 2.5배까지 올려 주지만, 생각에 쓰는 시간까지 줄여 준다는 설명은 없어요.
느린 대신 틀리지 않는 쪽에서는 성적이 확실해요. 스킨케어 브랜드의 12개월 광고 예산을 굴리는 ROASBench에서 61.3점으로 28개 모델 중 1위였고, 한 달도 예산을 넘기지 않았어요. 앤트로픽은 페이블 5.2 에이전트 1,000개가 30시간 만에 페르마의 마지막 정리를 Lean으로 형식화했다는 사례도 냈고요(같은 방식의 오퍼스 5.5는 18시간에 26%).
이번 주에 해 볼 수 있는 비교
앤트로픽은 출시 주간 프로모션으로, 페이블이 포함된 유료 플랜에 구독 기간에 따라 1~3회의 페이블 사용량 리셋을 주고 있어요. 프로(Pro) 요금제와 팀(Team) 요금제 표준 시트는 주간 한도의 최대 50%까지 페이블을 쓸 수 있고요. API 비용 없이 써 볼 수 있는 기회인 만큼, 평소 오퍼스 5.5에 맡기던 작업 중 가장 오래 붙잡고 있던 것 하나를 골라 두 모델에 똑같이 넣어 보는 걸 권해요. API로 옮길지는 그다음에 앞의 네 칸을 비교해서 정해도 늦지 않아요. 단가표의 20%는 어느 작업에서나 같지만, 청구서의 숫자는 작업마다 다르게 나오니까요.